2026.10.04 06:00
 2026.10.03 23:57
●この記事のポイント
面接で高評価だった人が入社後に伸び悩むのはなぜか。採用面接の評価の仕組みから原因を解説する。Sackettらの2022年の再分析では、構造化面接の予測妥当性は0.42で最も高く、非構造化面接は0.19にとどまった。記事では、STAR面接の深掘り質問とルーブリックの作り方、生成AIで面接ログを点検する手順を紹介する。あわせて、AIの評価の偏りやEU AI規則の2027年適用といった注意点も整理した。
面接では評価が高かったのに、入社してみると思ったほど成果が出ない。採用に関わる人なら一度は経験する「ずれ」だ。原因を候補者個人に求める前に、面接という道具そのものの精度を疑ってみたい。人事測定研究の最新の知見と、生成AIを使った面接ログ分析の現実的な使い方から、評価を標準化するための手順を整理する。
●目次
- 「話がうまい」と「仕事ができる」は別の能力
- 数字が示す構造化面接の優位
- STARは「過去の行動」を取り出す型
- 面接官のばらつきを減らす「質問」と「物差し」
- 生成AIは「判定者」ではなく「点検役」として使う
- 成果は「入社後」でしか確かめられない
- 面接は「行動の再現性」を確かめる場
「話がうまい」と「仕事ができる」は別の能力
話しぶりに説得力がある。有名企業での実績を淀みなく語れる。こうした候補者に高い点がつくのは自然なことだ。ただ、面接官が見ているのは多くの場合「説明する力」であって、「同じ状況で同じ行動を再現できるか」ではない。この二つが混ざったまま評価が下される。
加えて、人の判断には癖がある。一つの目立つ長所が全体の印象を引き上げる「ハロー効果」は、心理学者ソーンダイクが1920年に報告して以来、繰り返し確認されてきた。自分と経歴や話し方が似た相手を高く見る「類似性バイアス」もある。質問も評価基準も面接官任せの「非構造化面接」では、こうした癖を抑える仕組みがない。
「面接の失敗は、面接官の能力不足というより設計の問題です。同じ質問をしない、同じ物差しで採点しない。これでは、誰が面接しても結果がぶれます」(人事労務コンサルタント、社会保険労務士・松田美里氏)
数字が示す構造化面接の優位
採用手法の予測精度を語るとき、長く引用されてきたのがシュミットとハンターの1998年のメタ分析だ。構造化面接の妥当性係数(入社後の業績との相関)を0.51、非構造化面接を0.38としていた。
この数字は2022年に見直された。米ミネソタ大学のサケット教授らが学術誌「Journal of Applied Psychology」で、過去の分析が統計補正をかけすぎて数値を膨らませていたと指摘し、推定をやり直したのだ。
手法 1998年推定 2022年改訂
構造化面接 0.51 0.42
非構造化面接 0.38 0.19
改訂で全体の数値は下がった。それでも構造化面接は、一般知的能力テスト(0.31)を上回り、調べた手法の中で最も高い平均値となった。非構造化面接との差はむしろ開いている。
注意点もある。構造化面接の数値はばらつきが大きく、80%信用区間は0.18〜0.66と幅広い。「構造化すれば必ず当たる」のではなく、設計と運用の質で精度が大きく変わる、と読むのが正確だ。
STARは「過去の行動」を取り出す型
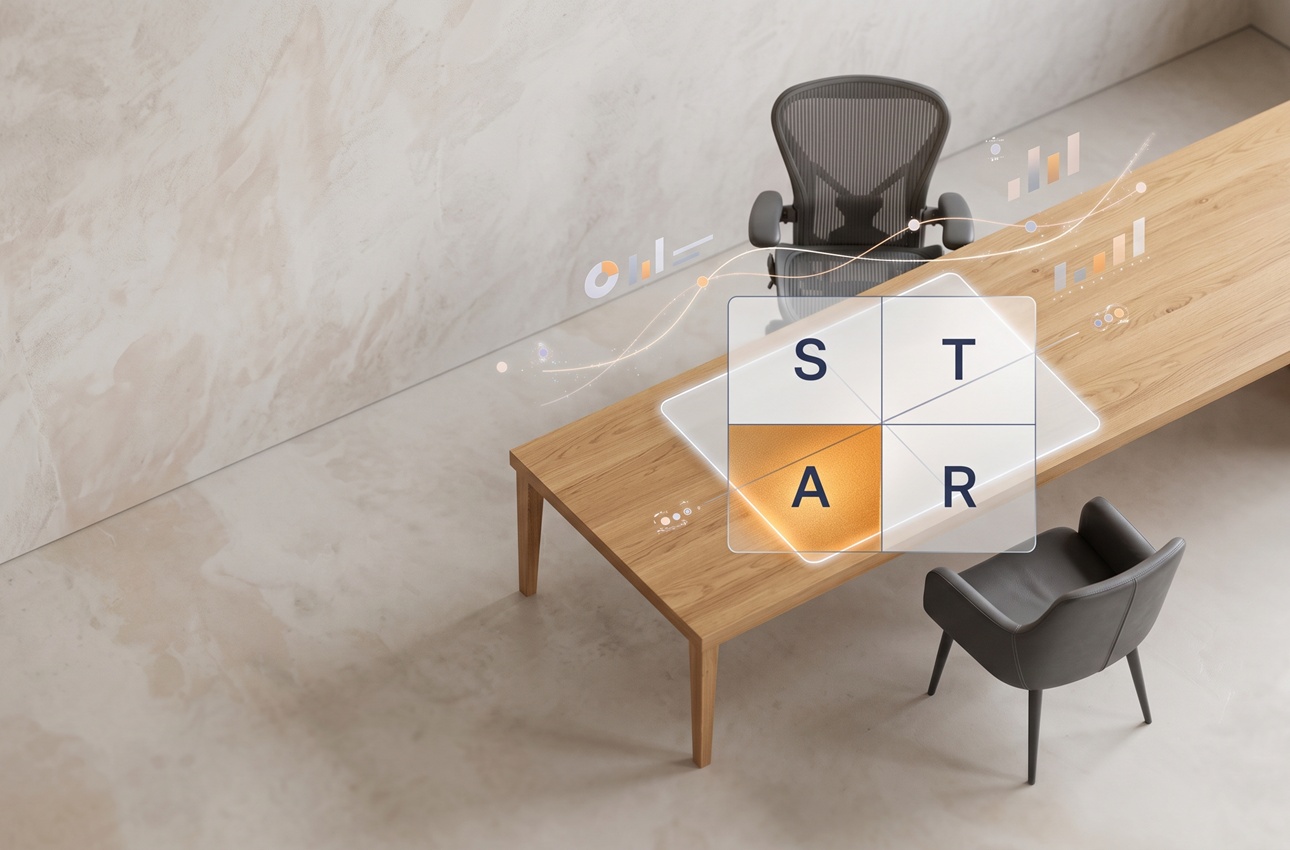
構造化面接の代表的な形式が、過去の具体的な経験を聞く行動面接だ。回答をS(状況)、T(課題・役割)、A(本人の行動)、R(結果)に分けて聞く「STAR」が現場では広く使われている。意気込みや仮定の話ではなく、実際に起きたことを材料にする点がポイントになる。
多くの面接で抜け落ちるのがAだ。チームの成果(R)や状況説明(S)を聞いて満足してしまい、「その中で本人が何を考え、何を選んだか」まで掘り下げないまま評価してしまう。
面接官のばらつきを減らす「質問」と「物差し」
構造化面接の精度を支える要素について、レバシナらが2014年に学術誌「Personnel Psychology」で行ったレビューは、同じ質問を同じ順で聞くこと、評価尺度を固定すること、面接官が個別に採点してから話し合うことなどを挙げている。現場で最低限そろえたいのは次の三点だ。
1. 共通の設問
「直近3年で最も難しかったトラブルと、解決までの経緯を教えてください」のように、職務に必要な能力と結びついた設問を全候補者に同じ形で聞く。
2. 深掘りの定型句
候補者が「〜という方針で進めました」と総論で答えたら、次のように切り返す。
「その方針に決める前に、ほかにどんな選択肢を検討しましたか」(判断の過程を確かめる)
「反対意見が出たとき、あなたご自身は誰に、どう働きかけましたか」(本人の行動を特定する)
主語が「私たち」「弊社」のままなら、「その中であなたが担った部分は」と一段絞る。これだけでAの情報量はかなり変わる。
3. 行動で書いたルーブリック
評価項目ごとに、点数の目安を「行動」で書いておく。例えば「問題解決力」なら次のようになる。
評価 回答に見られる行動の例
S 原因を自ら仮説立てして検証し、再発防止の仕組みまで手を打った
A 原因を特定し、関係者を動かして解決まで導いた
B 指示された対応を確実に実行したが、原因分析は他者に依存
C 本人の行動が具体的に語られない
「主体性がある」のような形容詞で基準を書くと、面接官ごとに解釈が割れる。行動の記述にしておけば、評価の根拠を後から突き合わせやすい。
「ルーブリックは一度作って終わりではありません。入社後の評価と照らし合わせて、どの記述が実際の活躍と結びついていたかを見直していく。そこまでやって初めて自社の物差しになります」(同)
生成AIは「判定者」ではなく「点検役」として使う
ここ数年、オンライン面接の普及で、面接の録音や文字起こしが手元に残るようになった。これを生成AIで整理すれば、面接官の聞き方や採点を振り返る材料になる。手順は大きく三つだ。
記録と同意:録音・文字起こしの前に、利用目的を候補者に伝えて了承を得る。
STARへの分解:文字起こしをAIに渡し、「候補者が個人として取った行動だけを抜き出し、主語が『チーム』『会社』の発言とは分けて整理せよ」と指示する。Aが薄い回答、深掘りが足りなかった箇所が一覧で見える。
採点の照合:ルーブリックを読み込ませてAIにも根拠付きで評価させ、面接官の点数と大きくずれた項目だけを人が見直す。甘すぎる・厳しすぎる傾向を面接官本人にフィードバックする材料になる。
気をつけたいのは、AIにも癖がある点だ。大規模言語モデルを評価者として使う研究では、回答の提示順や長さに引っ張られる傾向が報告されている。長く流暢に話した候補者が有利になるなら、人間の「話のうまさバイアス」をそのまま持ち込むことになりかねない。AIの点数は合否の決め手ではなく、面接官の判断を点検するための参考値にとどめるのが筋だ。
法令面の確認も欠かせない。国内では職業安定法が、求職者の個人情報の収集・利用を業務の目的に必要な範囲に限るよう求めている。録音データの保管期間や、AIサービス側での学習利用の有無は、導入前に規程と契約で決めておきたい。欧州ではAI規則が採用候補者の評価に使うAIを「高リスク」に分類しており、その義務の適用開始は2026年の改正で2027年12月2日に延期された。延期であって撤回ではない。欧州で採用活動を行う企業は、人による監督や記録の仕組みを今から整えておく必要がある。
「AIに任せられるのは、整理と比較までです。誰を採るかの責任は人が負う。その線引きを社内で明文化しておかないと、候補者にも説明がつきません」(同)
成果は「入社後」でしか確かめられない
仕組みを入れたら、効果を測る指標も決めておく。目安になるのは次の三つだ。
面接官間の一致度:同じ候補者に対する複数面接官の点数のずれ
選考段階間の整合:一次面接の高評価者が、最終面接でどの程度通過しているか
入社後との相関:面接での点数と、入社1年後の業績評価との関係
三つ目は結果が出るまで時間がかかり、採用人数が少ないと統計的な結論も出しにくい。それでも、面接の点数と入社後の評価を同じ表に並べて記録し続ける企業は、自社の面接が何を当てていて、何を外しているかを数年単位で学べる。前述の通り構造化面接の精度は運用次第で大きく振れる。自社の数字で検証することが、その振れ幅を上側に寄せる唯一の方法だろう。
面接は「行動の再現性」を確かめる場
面接の精度を上げるのは、面接官の勘を磨くことよりも、同じ質問・同じ物差し・独立した採点という地味な仕組みのほうだ。2022年の再分析は、構造化面接の優位を改めて示す一方で、その効果が設計と運用に左右されることも明らかにした。生成AIはその運用を点検する道具として役に立つが、AI自身の偏りと法的な責任の所在を踏まえて使う必要がある。「印象の良い人」ではなく「自社で同じ行動を繰り返せる人」を選ぶ。面接の役割をそう捉え直すところから始めたい。
(文=BUSINESS JOURNAL編集部、協力=松田美里/人事労務コンサルタント、社会保険労務士)
【主な参照データ・出典】
SIOP: Is Cognitive Ability the Best Predictor of Job Performance?(Sackett et al. 2022の解説)
100Hires: Structured interviews(改訂値の比較)
MASTER HR: Insights from Sackett et al.(80%信用区間)
Truffle: Levashina et al. 2014の要約
Zheng et al. 2023, Judging LLM-as-a-Judge(arXiv)
Gibson Dunn: EU AI Act Omnibus Agreement

RANKING
RELATED POSTS
ニューアングル